La mémoire de traduction (Translation Memory) : comment elle fait gagner du temps et de l'argent
Imaginez la situation suivante : une grande entreprise industrielle publie la mise à jour annuelle du manuel d'utilisation d'un équipement complexe de trois cents pages. Les modifications ne concernent que quelques éléments techniques et moins de cinq pour cent du texte d'origine a été réécrit. Pourtant, un gestionnaire inexpérimenté envoie le document à une agence et reçoit une facture pour la traduction intégrale des trois cents pages à partir de zéro. Payer deux, trois ou même dix fois pour la traduction des mêmes phrases constitue l'une des erreurs financières les plus courantes et les plus regrettables dans le monde de l'entreprise. La technologie de la mémoire de traduction (Translation Memory) permet d'éviter ces dépenses injustifiées, transformant en profondeur l'économie de la localisation internationale et instaurant des règles claires de collaboration entre les entreprises et les prestataires. Dans cet article, nous analysons en détail le fonctionnement d'une mémoire de traduction, les principes de calcul des économies réelles pour le client et les raisons pour lesquelles cette base de données s'impose comme le principal actif numérique stratégique de toute marque internationale.
Qu'est-ce qu'une base de mémoire de traduction et en quoi diffère-t-elle des réseaux neuronaux
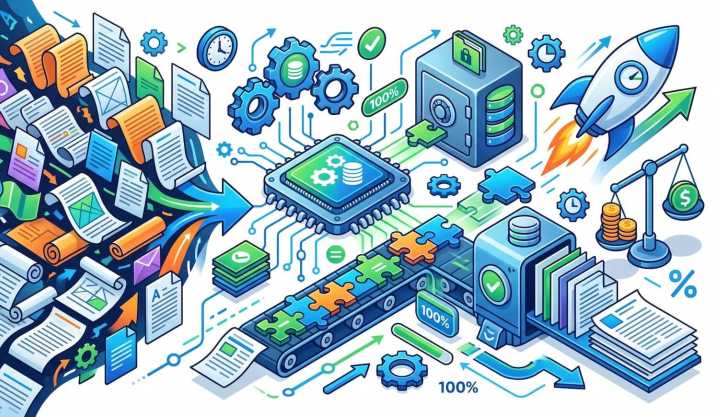
Parmi les acheteurs de prestations linguistiques, la confusion persiste souvent entre le concept de mémoire de traduction et les algorithmes de traduction automatique. Il convient de souligner une différence fondamentale : la mémoire de traduction n'a aucun lien avec l'intelligence artificielle, les réseaux génératifs ou les déductions probabilistes des algorithmes. Il s'agit d'une base de données dynamique, continuellement enrichie, composée exclusivement de paires de phrases ayant déjà été traduites par un être humain et validées par un réviseur qualifié.
Chaque entrée de cette base est appelée unité de traduction ou segment. Sur le plan structurel, elle associe la phrase source à son équivalent exact dans la langue cible. Lorsqu'un linguiste ouvre un nouveau fichier dans un logiciel de traduction assistée par ordinateur, le système analyse instantanément l'intégralité du texte et compare chaque phrase avec l'historique des projets archivés. Si une phrase a déjà été rencontrée, le logiciel propose immédiatement la version existante. Alors que la traduction automatique régénère le texte sur la base de régularités statistiques ou de pondérations neuronales, la mémoire de traduction extrait une solution éprouvée, harmonisée et approuvée par l'humain. Grâce à ce procédé, la traduction professionnelle conserve une fiabilité totale et une conformité sémantique irréprochable.
Le mécanisme des correspondances : des correspondances parfaites à la recherche approximative
La puissance de la mémoire de traduction repose sur un système de classification des correspondances rigoureusement calibré. Le logiciel répartit l'ensemble du volume analysé en plusieurs catégories qui déterminent la charge de travail réelle du traducteur.
La première catégorie comprend les correspondances exactes à cent pour cent, lorsque la nouvelle phrase reproduit fidèlement, au caractère près, un segment présent dans la base de données. Une variante encore plus sûre est la correspondance contextuelle, souvent appelée correspondance à 101 pour cent ou In-Context Exact Match. Dans ce cas, la correspondance porte non seulement sur la phrase elle-même, mais également sur les phrases précédente et suivante, ce qui écarte tout risque d'erreur sémantique liée à un changement de contexte ou à des particularités de mise en page.
La catégorie suivante concerne les correspondances partielles, ou Fuzzy Matches. Le système calcule le degré de similitude entre la nouvelle phrase et le segment archivé, dans une fourchette allant généralement de soixante-quinze à quatre-vingt-dix-neuf pour cent. Par exemple, si dans une nouvelle notice seul le modèle d'un appareil ou la valeur chiffrée d'un paramètre a changé, le programme affiche l'ancienne version et met clairement en évidence la portion nécessitant une retouche ciblée. Enfin, les répétitions internes au document lui-même sont comptabilisées sur une ligne distincte. Si un slogan, un en-tête de tableau ou un avertissement de sécurité apparaît cinquante fois au fil d'un manuel, le linguiste ne le traduit qu'une seule fois, et le logiciel répercute automatiquement la solution sur l'ensemble du fichier.
Des économies budgétaires concrètes : le fonctionnement de la grille tarifaire
L'existence d'une gradation précise des correspondances a donné naissance à une norme de facturation universelle dans le secteur mondial de la traduction, connue sous le nom de grille d'analyse ou grille TAO. Avant d'engager le travail, la suite logicielle analyse les fichiers fournis et génère un rapport détaillé ventilant précisément les mots par catégorie.
Sur la base de ce rapport, le donneur d'ordre ne rémunère pas le projet selon un tarif forfaitaire unique, mais selon un barème dégressif. Les segments entièrement nouveaux, sans équivalent dans la base, sont facturés au tarif plein. Pour les correspondances partielles à fort taux de similarité, le client ne paie que trente à cinquante pour cent du tarif de base, puisqu'il suffit au professionnel d'adapter rapidement quelques termes. Pour les correspondances exactes, contextuelles et les répétitions internes, le tarif appliqué est minime, voire nul si le projet ne requiert pas de relecture humaine supplémentaire.
Dans les projets de grande ampleur portant sur de la documentation technique, des contrats juridiques types ou des interfaces logicielles, l'adoption de cette technologie permet aux entreprises d'économiser durablement entre trente et soixante pour cent de leur budget global.
Harmonisation de la terminologie et travail d'équipe coordonné
Au-delà de l'avantage financier direct, la mémoire de traduction résout le défi essentiel de l'homogénéité terminologique. Au sein des grandes entreprises, plusieurs dizaines de spécialistes répartis dans le monde entier peuvent collaborer simultanément à la localisation d'un même produit. Les plateformes dans le cloud, telles que Trados, memoQ, Smartcat ou Phrase, permettent aux linguistes de se connecter à une base de données centralisée unique en temps réel.
Dès qu'un spécialiste traduit et valide la désignation complexe d'une pièce ou le libellé d'une fonction logicielle, ce segment devient instantanément accessible à tous les autres intervenants du groupe de travail. De cette manière, on élimine les incohérences regrettables, comme le fait qu'un même bouton d'application porte des noms différents d'un écran à l'autre. Les difficultés de traduction inhérentes à la coordination d'une vaste équipe distribuée sont parfaitement jugulées par les outils intégrés d'assurance qualité et de contrôle terminologique.
Les atouts pour le linguiste : rapidité et liberté créative
Il n'est pas rare que les traducteurs débutants redoutent que les outils d'automatisation ne dévalorisent leurs compétences. Dans les faits, un professionnel chevronné perçoit la base de données constituée comme un assistant numérique incontournable.
Cette technologie libère l'humain d'une routine mécanique épuisante. Le traducteur n'a plus besoin de saisir manuellement de longues mentions légales, des listes de centres de service, des clauses types ou des tableaux de caractéristiques techniques répétitifs. Le rythme de travail confortable du linguiste est multiplié par deux ou trois, atteignant quatre à cinq mille mots par journée de travail. Les ressources intellectuelles ainsi libérées sont réinvesties dans des tâches créatives à haute valeur ajoutée : l'adaptation de métaphores complexes, le polissage de titres accrocheurs et la révision stylistique approfondie des sections stratégiques.
Propriété de la base et règles d'entretien
Un enjeu capital, que tout donneur d'ordre prévoyant doit garder à l'esprit, concerne la propriété des données linguistiques accumulées. La mémoire de traduction est un actif stratégique du client, financé sur son propre budget. À l'issue du projet, le fichier de la base de données au format graphique international TMX doit être remis au client en même temps que les textes traduits.
Cette base doit par ailleurs faire l'objet d'un entretien rigoureux. Au fil du temps, les procédures internes évoluent, les slogans marketing se renouvellent et les normes techniques deviennent obsolètes. Si l'on ne procède pas régulièrement à un audit pour supprimer les segments périmés, le système continuera de proposer des formulations dépassées lors des nouvelles publications. Un nettoyage périodique et une bonne gestion des glossaires garantissent un niveau d'excellence constant au fil des années, facilitant le traitement des difficultés de traduction à mesure que l'entreprise se développe.
Conclusions pratiques pour la réussite de vos projets
La mémoire de traduction a depuis longtemps cessé d'être une simple innovation pour devenir un standard incontournable de toute prestation linguistique de qualité. Si votre entreprise traduit régulièrement des documents institutionnels, actualise des catalogues ou gère un site web multilingue, la constitution de votre propre mémoire de traduction doit être une priorité absolue.
Les donneurs d'ordre doivent exiger dès le départ de leurs partenaires l'utilisation d'outils d'automatisation et la communication de rapports d'analyse transparents, tout en veillant à conserver et enrichir leurs fichiers TMX. Pour les linguistes, la maîtrise de ces outils professionnels est indispensable, car c'est l'alliance d'un traducteur qualifié et de technologies avancées qui forge une traduction professionnelle moderne de premier ordre. Une utilisation judicieuse de la mémoire de traduction prémunit l'entreprise contre les dépenses superflues, garantit une rigueur terminologique irréprochable et trace la voie la plus directe vers une expansion internationale couronnée de succès.