Översättningsminne (Translation Memory): hur det sparar tid och pengar
Föreställ dig situationen: ett stort tillverkningsföretag släpper en årlig uppdatering av användarmanualen för en komplex industriell utrustning på trehundra sidor. Ändringarna rörde bara ett fåtal tekniska enheter, inte mer än fem procent av källtexten skrevs om, men en oerfaren chef skickar dokumentet till en byrå och får en faktura på hela kostnaden för att översätta alla trehundra sidor från grunden. Att betala två, tre eller till och med tio gånger för att översätta samma meningar är ett av de vanligaste och mest förargliga ekonomiska misstagen inom företagssektorn. Att undvika sådana orättfärdiga utgifter möjliggörs av tekniken Translation Memory, som i grunden har förändrat ekonomin för internationell lokalisering och etablerat transparenta samarbetsregler mellan näringsliv och utförare. I det här materialet analyserar vi i detalj hur ett översättningsminne är uppbyggt, enligt vilka principer beställarens verkliga besparing beräknas och varför denna databas blir den främsta strategiska digitala tillgången för varje globalt varumärke.
Vad en Translation Memory-databas är och hur den skiljer sig från neurala nätverk
Bland beställare av språktjänster råder det fortfarande ofta förvirring mellan konceptet Translation Memory och maskinöversättningsalgoritmer. Det är viktigt att understryka den grundläggande skillnaden: ett översättningsminne har ingenting att göra med artificiell intelligens, generativa nätverk eller algoritmers sannolikhetsgissningar. Det är eine dynamisk, kontinuerligt påfylld databas som uteslutande består av meningspar som tidigare har översatts av en människa och granskats av en kvalificerad redaktör.
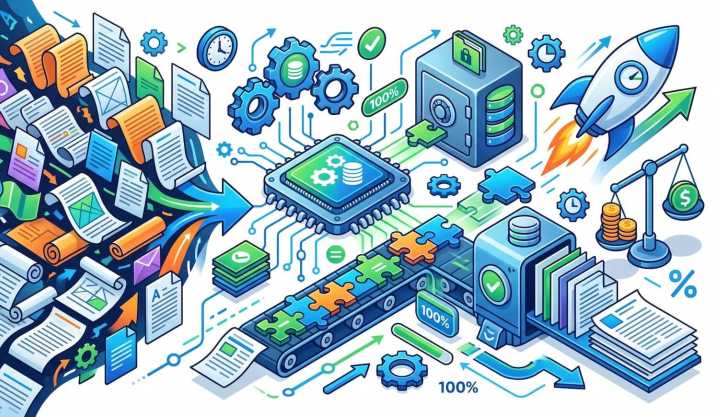
Varje post i en sådan databas kallas för en översättningsenhet eller ett segment. Strukturellt förenar den källmeningen och dess exakta motsvarighet på målspråket. När en lingvist öppnar en ny fil i ett specialiserat datorstött översättningsverktyg analyserar systemet omedelbart hela texten och jämför varje mening med den insamlade projekthistoriken. Om frasen redan har förekommit tidigare infogar programmet genast den färdiga varianten. Medan maskinöversättning genererar text på nytt baserat på statistiska mönster eller neurala vikter, hämtar ett översättningsminne en beprövad, samordnad och av människan godkänd lösning. Tack vare detta behåller eine professionell översättning hundraprocentig tillförlitlighet och eine felfri innehållsmässig överensstämmelse.
Matchningsmekaniken: från exakta träffar till luddig sökning
Styrkan hos Translation Memory-tekniken ligger i ett matematiskt precist system för klassificering av matchningar. Programvaran delar in hela volymen av den analyserade texten i flera kategorier som avgör specialistens verkliga arbetsinsats.
Den första kategorin är hundraprocentiga matchningar, då eine ny mening bokstav för bokstav upprepar ett segment från databasen. Ett ännu säkrare alternativ anses vara kontextuell matchning, ofta betecknad som 101 procent eller In-Context Exact Match. I detta fall överensstämmer inte bara själva meningen, utan även föregående och efterföljande fraser, vilket helt utesluter risken för innebördsfel på grund av ändrat sammanhang eller specifik layout.
Nästa kategori kallas icke-exakta matchningar, eller Fuzzy Matches. Systemet beräknar graden av likhet mellan den nya meningen och den som finns i databasen i ett intervall från sjuttiofem till nittionio procent. Om det i eine ny manual till exempel bara är apparatens modell eller eine enskild siffra i eine parameter som har ändrats, visar programmet specialisten den gamla versionen och markerar tydligt det fragment som kräver punktvis redigering. Slutligen räknas interna upprepningar inom själva dokumentet på eine separat rad. Om eine slogan, eine tabellrubrik eller eine säkerhetsvarning upprepas femtio gånger i manualen översätter lingvisten den bara eine gång, och systemet duplicerar automatiskt lösningen genom hela filen.
Reella budgetbesparingar: hur rabattskalan fungerar
Förekomsten av eine tydlig gradering av matchningar har gett upphov till eine allmänt accepterad standard för avräkning i den globala branschen, känd som CAT-grid eller projektets analysmatris. Innan det faktiska arbetet påbörjas skannar programvaran de tillhandahållna filerna och genererar eine detaljerad rapport med exakt fördelning av orden över kategorierna.
Utifrån denna rapport betalar beställaren inte projektet enligt eine enhetlig grundtaxa, utan enligt eine differentierad skala. För helt nya segment, som saknar motsvarighet i databasen, debiteras full arbetskostnad. För icke-exakta matchningar med hög likhetsgrad betalar kunden endast trettio eller femtio procent av grundtaxan, eftersom det räcker för specialisten att snabbt redigera ett fåtal tecken. För hundraprocentiga och kontextuella matchningar samt interna upprepningar är taxan minimal, eller så tas ingen avgift alls ut om projektet inte kräver eine andra expertgranskning.
I storskaliga projekt för lokalisering av teknisk dokumentation, juridiska standardavtal eller programvarugränssnitt gör införandet av denna teknik det möjligt för företag att löpande spara mellan trettio och sextio procent av den totala budgeten.
Terminologisk enhetlighet och samspelt lagarbete
Utöver den direkta ekonomiska vinsten löser översättningsminnet den kritiskt viktiga uppgiften att säkerställa terminologisk enhetlighet. I stora företag kan dussintals specialister från olika länder arbeta samtidigt med lokaliseringen av eine och samma produkt. Molnbaserade plattformar som Trados, memoQ, Smartcat eller Phrase gör det möjligt för lingvister att ansluta till eine gemensam centraliserad databas i realtid.
Så snart eine specialist översätter och godkänner eine komplicerad komponentbenämning eller eine gränssnittsfunktion blir detta segment omedelbart tillgängligt för alla andra medlemmar i arbetsgruppen. Som ett resultat utesluts förargliga avvikelser, som att samma knapp i eine applikation benämns med olika termer på intilliggande skärmar. Alla översättningssvårigheter som är förknippade med att koordinera ett stort distribuerat team hanteras framgångsrikt genom inbyggda verktyg för kvalitetskontroll och terminologikontroll.
Fördelar för lingvisten: snabbhet och kreativt fokus
Det händer inte sällan att oerfarna skribenter fruktar att automatiseringssystem devalverar deras kompetens. I praktiken betraktar dock den erfarne översättaren databasen med samlat material som eine oumbärlig digital assistent.
Tekniken befriar människan från utmattande mekanisk rutin. Specialisten behöver inte längre skriva av skrymmande ansvarsfriskrivningar, adresser till servicecenter, standardiserade juridiska förbehåll eller återkommande specifikationstabeller manuellt. Hastigheten för lingvistens bekväma arbete ökar med två eller tre gånger och når fyra till fem tusen ord per arbetspass. De frigjorda intellektuella resurserna riktas istället mot att lösa okonventionella kreativa uppgifter: att anpassa komplexa metaforer, finslipa säljande rubriker och genomföra eine djupgående stilistisk granskning av nyckelavsnitt.
Vem som äger databasen och regler för omsorgsfull hantering
Den viktigaste frågan som varje framsynt beställare måste komma ihåg gäller äganderätten till de insamlada språkliga data. Ett översättningsminne är kundens strategiska tillgång, betald ur dess företagsbudget. När projektet slutförs ska databasfilen i det internationellt vedertagna TMX-formatet överlämnas till beställaren tillsammans med den färdiga texten.
Samtidigt måste databasen skötas på ett kompetent sätt. Med tiden förändras företagets regelverk, marknadsföringsslogans uppdateras eller tekniska normer blir förlegade. Om man inte regelbundet genomför granskningar och tar bort inaktuella segment ur databasen fortsätter systemet att tjänstvilligt föreslå föråldrade formuleringar i nya utgåvor. Regelbunden rensning och administration av ordlistor garanterar ett stabilt och högt resultat under många år och gör det lätt att övervinna alla översättningssvårigheter när verksamheten expanderar.
Praktiska slutsatser för framgångsrika projekt
Tekniken Translation Memory har för länge sedan övergått från att vara eine innovation till att bli eine obligatorisk standard för kvalitativt språkarbete. Om ditt företag regelbundet översätter företagsdokument, uppdaterar kataloger eller utvecklar eine flerspråkig webbplats bör skapandet av eine egen översättningsdatabas vara ett prioriterat första steg.
Beställare bör från början kräva att leverantörer tillämpar automatiserade system och transparenta rapporter enligt matchningsskalan, samt omsorgsfullt spara och vidareutveckla sina TMX-filer. För facköversättare är det viktigt att behärska professionella verktyg, eftersom det är just eine kvalificerad översättare i kombination med avancerad teknik som formar modern professionell översättning av högsta klass. Ett genomtänkt utnyttjande av översättningsminnet skyddar verksamheten tillförlitligt mot onödiga utgifter, garanterar oklanderlig terminologisk precision och öppnar den snabbaste vägen till framgångsrik internationell expansion.