Memoria de traducción (Translation Memory): cómo ahorra tiempo y dinero
Imagine esta situación: una gran empresa manufacturera publica la actualización anual del manual de usuario para una maquinaria industrial compleja, un documento de trescientas páginas. Las modificaciones afectaron únicamente a unos pocos componentes técnicos y no se reescribió más del cinco por ciento del texto original; sin embargo, un gestor inexperto envía el documento a una agencia y recibe una factura por el coste total de traducir las trescientas páginas desde cero. Pagar dos, tres o incluso diez veces por traducir las mismas frases constituye uno de los errores financieros más comunes y perjudiciales en el ámbito corporativo. Evitar este tipo de gastos injustificados es posible gracias a la tecnología Translation Memory, que transformó de raíz la economía de la localización internacional y definió pautas transparentes de colaboración entre empresas y proveedores. En este artículo analizaremos en profundidad cómo funciona la memoria de traducción, bajo qué criterios se determina el ahorro real para el cliente y por qué esta base de datos se consolida como el principal activo digital estratégico de cualquier marca global.
Qué es la base de Translation Memory y en qué se diferencia de las redes neuronales
Entre los contratantes de servicios lingüísticos todavía suele existir confusión entre el concepto de Translation Memory y los algoritmos de traducción automática. Conviene subrayar una distinción fundamental: la memoria de traducción no guarda relación alguna con la inteligencia artificial, las redes generativas ni las conjeturas probabilísticas de los algoritmos. Se trata de una base de datos dinámica y en constante crecimiento, compuesta con exclusividad por pares de oraciones que con anterioridad fueron traducidas por una persona y revisadas por un corrector cualificado.
Cada registro contenido en dicha base se denomina unidad de traducción o segmento. Desde el punto de vista estructural, asocia la oración de origen con su equivalente exacto en la lengua de destino. Cuando el lingüista abre un nuevo archivo en un software de traducción asistida, el sistema analiza al instante el texto completo y contrasta cada frase con el historial acumulado de los proyectos. Si la expresión ya se había traducido con anterioridad, el programa inserta de inmediato la opción ya existente. Mientras que la traducción automática genera texto nuevo apoyándose en regularidades estadísticas o ponderaciones neuronales, la memoria de traducción recupera una formulación contrastada, consensuada y aprobada por un ser humano. Gracias a ello, la traducción profesional preserva una fiabilidad absoluta y una rigurosa correspondencia conceptual.
Mecánica de las coincidencias: de las concordancias exactas a la búsqueda difusa
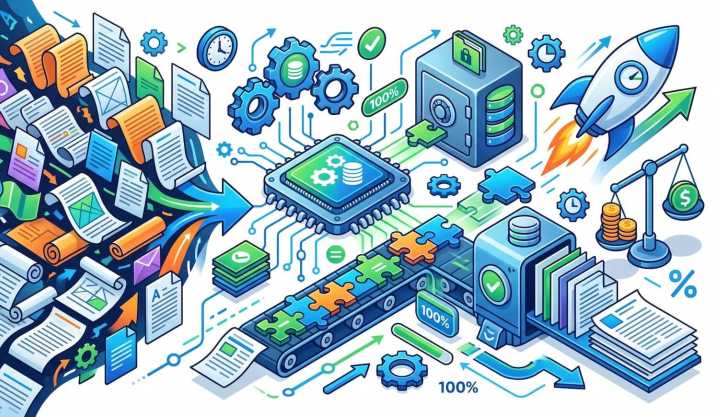
La fortaleza de la tecnología Translation Memory reside en un sistema de clasificación de coincidencias matemáticamente riguroso. El software divide el volumen total del texto analizado en distintas categorías que marcan la carga real de trabajo para el especialista.
La primera categoría corresponde a las coincidencias al cien por cien, en las que la nueva oración reproduce con exactitud de caracteres un segmento de la base de datos. Una alternativa todavía más fiable es la coincidencia contextual, a menudo designada como ciento uno por ciento o In-Context Exact Match. En tal caso coincide no solo la oración en sí, sino también la frase precedente y la posterior, lo que descarta cualquier riesgo de error conceptual derivado de cambios de contexto o particularidades de maquetación.
La siguiente categoría comprende las coincidencias parciales, denominadas Fuzzy Matches. El sistema estima el grado de similitud entre la nueva oración y la almacenada en la base en un rango que oscila entre el setenta y cinco y el noventa y nueve por ciento. Por ejemplo, si en un manual renovado únicamente cambió el modelo del equipo o una cifra concreta de un parámetro, el programa mostrará al especialista la versión anterior y resaltará con claridad el fragmento que precisa una corrección puntual. Por último, se contabilizan de forma independiente las repeticiones internas dentro del propio documento. Si un lema, el encabezado de una tabla o una advertencia de peligro figura cincuenta veces en el manual, el lingüista lo traduce una única vez y el sistema traslada automáticamente la solución a lo largo de todo el archivo.
Ahorro real de presupuesto: cómo funciona la escala de descuentos
La existencia de una clara escala de coincidencias dio lugar a un estándar de facturación generalizado en el sector internacional, conocido como tabla CAT o matriz analítica del proyecto. Antes de iniciar la labor técnica, la herramienta informática examina los archivos entregados y genera un informe pormenorizado con la distribución exacta de las palabras en cada categoría.
A partir de este informe, el cliente abona el proyecto aplicando una tarifa escalonada y no un precio base uniforme. Por los segmentos completamente nuevos, carentes de antecedentes en la base, se abona el importe íntegro de la tarifa. Por las coincidencias parciales con alto porcentaje de similitud, el contratante paga únicamente el treinta o el cincuenta por ciento de la tarifa de partida, ya que al profesional le basta con revisar superficialmente unos pocos caracteres. En cuanto a las coincidencias al cien por cien, las contextuales y las repeticiones internas, el coste es mínimo o nulo, salvo que el encargo exija una nueva lectura experta integral.
En planes de gran envergadura dedicados a la localización de manuales técnicos, contratos mercantiles tipificados o interfaces informáticas, la adopción continuada de esta tecnología permite a las empresas recortar de forma estable entre el treinta y el sesenta por ciento de su presupuesto acumulado.
Unidad terminológica y trabajo en equipo coordinado
Más allá del ahorro presupuestario directo, la memoria de traducción resuelve la necesidad crucial de garantizar la homogeneidad terminológica. En las multinacionales, en la localización de un mismo producto pueden intervenir de forma simultánea decenas de profesionales radicados en distintos países. Los entornos en la nube, tales como Trados, memoQ, Smartcat o Phrase, facilitan que los traductores se conecten en tiempo real a una base centralizada y compartida.
En cuanto un traductor traduce y valida la denominación compleja de una pieza o una función de la interfaz, dicho segmento queda de inmediato al alcance de todos los miembros del equipo de trabajo. De este modo se previenen discordancias desafortunadas, como que un mismo botón de una aplicación se denomine de formas dispares en pantallas consecutivas. Cualquier dificultad de traducción derivada de la coordinación de un grupo amplio y disperso se subsana eficazmente con las funciones integradas de control de calidad y revisión de terminología.
Ventajas para el lingüista: velocidad y enfoque creativo
Con frecuencia, los profesionales principiantes temen que las plataformas de automatización resten valor a su formación. En el ejercicio práctico, el traductor cualificado percibe la base de materiales acumulados como un asistente digital insustituible.
La tecnología libera al profesional de una rutina mecánica y extenuante. Ya no es necesario teclear a mano extensos descargos de responsabilidad, direcciones de centros de servicio técnico, cláusulas jurídicas estándar o tablas de especificaciones reiterativas. La cadencia de trabajo desahogada del lingüista se multiplica por dos o tres, alcanzando entre cuatro mil y cinco mil palabras por jornada. De este modo, la capacidad reflexiva liberada se orienta hacia retos de mayor creatividad: adaptar metáforas complejas, pulir titulares publicitarios y llevar a cabo una minuciosa revisión estilística de los apartados estratégicos.
A quién pertenece la base y pautas para su debido mantenimiento
Una cuestión de máxima relevancia que todo cliente previsor debe contemplar concierne a la titularidad de los datos lingüísticos generados. La memoria de traducción constituye un activo estratégico del cliente, sufragado con cargo a su presupuesto corporativo. Al concluir el encargo, el archivo de la base de datos en el formato internacional estandarizado TMX debe entregarse al cliente junto con el texto finalizado.
Asimismo, la base requiere un mantenimiento sistemático y riguroso. Con el transcurso del tiempo, en las organizaciones cambian las políticas internas, se renuevan los lemas promocionales o quedan desfasadas las especificaciones técnicas. Si no se audita con regularidad la base para depurar los segmentos caducos, el sistema continuará proponiendo formulaciones obsoletas en los nuevos lanzamientos. La depuración periódica y la gestión coordinada de glosarios aseguran un rendimiento excelente y constante a lo largo de los años, facilitando la superación de cualquier dificultad de traducción al escalar las operaciones del negocio.
Conclusiones prácticas para proyectos exitosos
La tecnología Translation Memory dejó atrás su condición de mera novedad técnica para consolidarse como un requisito imprescindible en la gestión lingüística de calidad. Si su empresa traduce periódicamente documentación corporativa, renueva catálogos de producto o gestiona un portal web multilingüe, la creación de una base de datos de traducciones propia ha de ser un paso prioritario.
Los contratantes deben exigir desde el inicio a sus proveedores el uso de herramientas de automatización e informes diáfanos basados en matrices de coincidencias, además de custodiar y ampliar diligentemente sus archivos TMX. Por su parte, los especialistas deben capacitarse en el manejo de entornos profesionales, pues es el traductor competente, en estrecha colaboración con tecnologías de vanguardia, quien hace posible una traducción profesional contemporánea del más alto nivel. La explotación estratégica de la base de traducciones protege a la empresa de desembolsos innecesarios, garantiza una coherencia terminológica intachable y allana el camino hacia una expansión internacional sólida y rentable.