Память переводов (Translation Memory): как это экономит время и деньги
Представьте ситуацию: крупная производственная компания выпускает ежегодное обновление руководства пользователя для сложного промышленного оборудования объемом в триста страниц. Изменения коснулись всего нескольких технических узлов, переписано не более пяти процентов исходного текста, однако неопытный менеджер отправляет документ в агентство и получает счет на полную стоимость перевода всех трехсот страниц с чистого листа. Платить дважды, трижды или даже десять раз за перевод одних и тех же предложений — одна из самых распространенных и досадных финансовых ошибок в корпоративном секторе. Избежать подобных неоправданных расходов позволяет технология Translation Memory, которая фундаментально изменила экономику международной локализации и установила прозрачные правила взаимодействия между бизнесом и исполнителями. В этом материале мы подробно разберем, как устроена память переводов, по каким принципам рассчитывается реальная выгода заказчика и почему эта база данных становится главным стратегическим цифровым активом любого глобального бренда.
Что такое база Translation Memory и чем она отличается от нейросетей
Среди заказчиков языковых услуг до сих пор нередко возникает путаница между концепцией Translation Memory и алгоритмами машинного перевода. Важно подчеркнуть принципиальную разницу: память переводов не имеет никакого отношения к искусственному интеллекту, генеративным сетям или вероятностным догадкам алгоритмов. Это динамическая, непрерывно пополняемая база данных, состоящая исключительно из пар предложений, которые ранее уже были переведены человеком и проверены квалифицированным редактором.
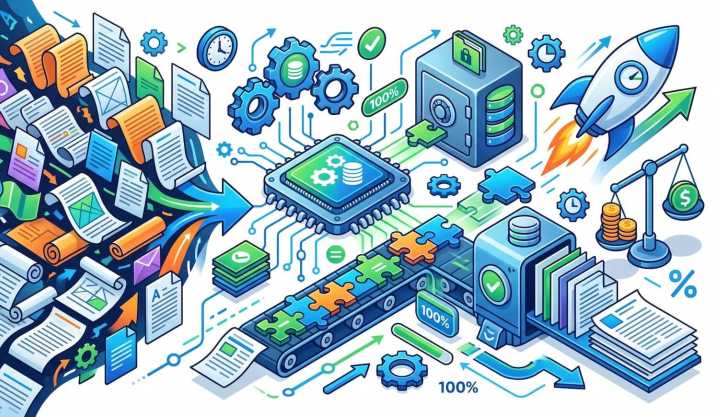
Каждая запись в такой базе именуется единицей перевода или сегментом. Структурно она объединяет исходное предложение и его точный эквивалент на целевом языке. Когда лингвист открывает новый файл в специализированной программе автоматизированного перевода, система моментально анализирует весь текст и сопоставляет каждое предложение с накопленной историей проектов. Если фраза уже встречалась ранее, программа мгновенно подставляет готовый вариант. В то время как машинный перевод генерирует текст заново на основе статистических закономерностей или нейронных весов, память переводов извлекает проверенное, согласованное и утвержденное человеком решение. Благодаря этому профессиональный перевод сохраняет стопроцентную надежность и безупречное смысловое соответствие.
Механика сопоставлений: от точных совпадений до нечеткого поиска
Сила технологии Translation Memory кроется в математически выверенной системе классификации совпадений. Программное обеспечение делит весь объем анализируемого текста на несколько категорий, определяющих реальные трудозатраты специалиста.
Первая категория — это стопроцентные совпадения, когда новое предложение буква в букву повторяет сегмент из базы данных. Еще более надежным вариантом считается контекстное совпадение, часто обозначаемое как 101 процент или In-Context Exact Match. В этом случае совпадает не только само предложение, но и предшествующая и последующая фразы, что полностью исключает риск смысловой ошибки из-за смены контекста или специфики верстки.
Следующая категория носит название нечетких совпадений, или Fuzzy Matches. Система вычисляет степень сходства нового предложения с имеющимся в базе в диапазоне от семидесяти пяти до девяноста девяти процентов. Например, если в новой инструкции изменилась только модель прибора или отдельная цифра параметра, программа покажет специалисту старый вариант и наглядно подсветит фрагмент, требующий точечной правки. Наконец, отдельной строкой учитываются внутренние повторы внутри самого документа. Если слоган, заголовок таблицы или предупреждение об опасности повторяется в руководстве пятьдесят раз, лингвист переводит его лишь однажды, а система автоматически тиражирует решение по всему файлу.
Реальная экономия бюджета: как работает шкала скидок
Наличие четкой градации совпадений породило общепринятый стандарт взаиморасчетов в глобальной индустрии, известный как CAT-сетка или аналитическая сетка проекта. До начала фактической работы программный комплекс сканирует предоставленные файлы и формирует подробный отчет с точным распределением слов по категориям.
На основе этого отчета заказчик оплачивает проект не по единой базовой ставке, а по дифференцированной шкале. За абсолютно новые сегменты, не имеющие аналогов в базе, начисляется полная стоимость работы. За нечеткие совпадения с высоким сходством клиент платит лишь тридцать или пятьдесят процентов от базового тарифа, поскольку специалисту достаточно бегло отредактировать несколько символов. За стопроцентные и контекстные совпадения, а также внутренние повторы ставка минимальна либо оплата вовсе не взимается, если проект не требует повторной экспертной вычитки.
В масштабных проектах по локализации технической документации, юридических типовых контрактов или интерфейсов программного обеспечения внедрение этой технологии позволяет компаниям на постоянной основе экономить от тридцати до шестидесяти процентов совокупного бюджета.
Единство терминологии и слаженная командная работа
Помимо прямой денежной выгоды память переводов решает критически важную задачу обеспечения терминологического единства. В крупных корпорациях над локализацией одного продукта могут одновременно трудиться десятки специалистов из разных стран. Облачные платформы, такие как Trados, memoQ, Smartcat или Phrase, позволяют лингвистам подключаться к единой централизованной базе в режиме реального времени.
Как только один специалист переводит и утверждает сложное наименование детали или функцию интерфейса, этот сегмент мгновенно становится доступен всем остальным участникам рабочей группы. В результате исключаются досадные расхождения, когда одна и та же кнопка в приложении на соседних экранах называется разными терминами. Любые сложности перевода, связанные с координацией большого распределенного коллектива, успешно нивелируются встроенными инструментами проверки качества и контроля терминологии.
Преимущества для лингвиста: скорость и творческий фокус
Нередко начинающие авторы опасаются, что системы автоматизации обесценивают их квалификацию. На практике же опытный переводчик воспринимает базу накопленных материалов как незаменимого цифрового помощника.
Технология избавляет человека от изнурительной механической рутины. Специалисту больше не нужно вручную перепечатывать громоздкие дисклеймеры, адреса сервисных центров, стандартные юридические оговорки или повторяющиеся таблицы характеристик. Скорость комфортной работы лингвиста возрастает в два или три раза, достигая четырех или пяти тысяч слов за рабочую смену. При этом освободившиеся интеллектуальные ресурсы направляются на решение нестандартных творческих задач: адаптацию сложных метафор, шлифовку продающих заголовков и глубокую стилистическую вычитку ключевых разделов.
Кому принадлежит база и правила бережного ухода
Важнейший вопрос, о котором обязан помнить каждый дальновидный заказчик, касается права собственности на накопленные лингвистические данные. Память переводов является стратегическим активом клиента, оплаченным из его корпоративного бюджета. По завершении проекта файл базы данных в общепринятом международном формате TMX должен передаваться заказчику вместе с готовым текстом.
При этом за базой необходимо грамотно ухаживать. Со временем в компании меняются регламенты, обновляются маркетинговые слоганы или устаревают технические нормативы. Если периодически не проводить аудит и не удалять из базы устаревшие сегменты, система продолжит услужливо подставлять неактуальные формулировки в новые релизы. Регулярная очистка и ведение глоссариев гарантируют стабильно высокий результат на протяжении многих лет, позволяя легко преодолевать любые сложности перевода при масштабировании бизнеса.
Практические выводы для успешных проектов
Технология Translation Memory давно перешла из разряда инноваций в категорию обязательных стандартов качественной языковой работы. Если ваше предприятие регулярно переводит корпоративные документы, обновляет каталоги или развивает мультиязычный веб-сайт, создание собственной базы переводов должно стать первоочередным шагом.
Заказчикам следует изначально требовать от подрядчиков применения систем автоматизации и прозрачных отчетов по шкале совпадений, а также бережно сохранять и развивать свои файлы TMX. Специалистам важно осваивать профессиональные инструменты, ведь именно квалифицированный переводчик в связке с передовыми технологиями формирует современный профессиональный перевод высочайшего класса. Грамотное использование базы переводов надежно защищает бизнес от лишних трат, гарантирует безупречную терминологическую точность и открывает кратчайший путь к успешной международной экспансии.